BigQuery を容量ベースの課金に切り替えてクエリ料金を削減する

こんにちは、CTOの小笠原(@yamitzky)です。この記事では、BigQuery のクエリ料金をオンデマンド課金から容量ベースの課金に切り替えて削減した取り組みについて書きます。以前書いた物理バイトストレージ課金への切り替えがストレージ側の話だったのに対して、今回はコンピュート(SQL実行)側の削減の話です。

ワークロード管理の2つのモデル

BigQuery の料金モデルには、オンデマンド課金と容量ベースの課金の2つのモデルがあります。

オンデマンド課金は、クエリが処理したバイト量(テーブルや使ったカラム、パーティションの大きさ)に対して課金されます。東京リージョンで $7.50/TiB です。裏で何スロット使われようと、読んだ量が同じなら料金は同じです。

容量ベースの課金は、消費した「スロット」に対して課金されます。こちらはスキャン量は直接は関係しません。

ここで「スロット」とは、BigQuery の SQL 実行に使われる計算量のようなもので、データ量やクエリの複雑さなどによって決まります。

つまり、「読んだデータ量そのもの」で費用を計算するか、「使った計算資源の総量」で費用を計算するか、という違いです。同じクエリでも料金の決まり方がまったく異なるので、どちらが安いかはワークロードの形によって変わります。

容量ベースの課金を選ぶ場合は、さらに Standard / Enterprise / Enterprise Plus の3つのエディションから選びます。私たちは Standard を選びました。東京リージョンで $0.051/slot-hour です。Enterprise は単価が1.5倍で、必要になる機能(BI Engine、列・行レベルセキュリティなど)を使っていなかったためです。

どちらが得かを事前に概算する

必要な数字は2つだけです。いまオンデマンドでいくら払っているかと、実際に何スロット時間使っているか。どちらも切り替える前に INFORMATION_SCHEMA から取れます。

-- 実際に消費したスロット時間
SELECT
  SUM(period_slot_ms) / 1000 / 3600 AS actual_slot_hours
FROM `region-asia-northeast1`.INFORMATION_SCHEMA.JOBS_TIMELINE_BY_ORGANIZATION
WHERE job_type = "QUERY"
  AND (statement_type != "SCRIPT" OR statement_type IS NULL)
  AND job_creation_time >= TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 30 DAY);

-- オンデマンド料金の定価換算
SELECT
  SUM(total_bytes_billed) / POW(1024, 4) * 6.25 AS ondemand_usd
FROM `region-asia-northeast1`.INFORMATION_SCHEMA.JOBS_BY_ORGANIZATION
WHERE job_type = "QUERY"
  AND (statement_type != "SCRIPT" OR statement_type IS NULL)
  AND creation_time >= TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 30 DAY);

前者にスロット単価を掛ければ容量ベースでの料金が出ます……と言いたいところですが、これは切り上げが一切起きなかった場合の金額、いわば最安値・理論値でしかありません。実際の請求は必ずこれを上回ります。というのも、スロットの自動スケーリングは50スロット刻みで動くので、ある瞬間に1スロットしか必要としていなくても50スロットぶん課金されるためです。

とはいえ、この最安値(理論値)といまのオンデマンド課金の費用を並べれば、どれだけ余裕があるかは分かります。JX通信社の場合、理論値としては、オンデマンド課金の 25%程度まで削減できる 見込みでした。実際に切り替えたあとの金額は、 オンデマンド課金の60%程度 までに収まりました。

実際に行った設定

予約を作り、プロジェクトを割り当てるだけです。

CREATE RESERVATION `ADMIN_PROJECT.region-asia-northeast1.main`
OPTIONS (
  edition = 'STANDARD',
  slot_capacity = 0,          -- ベースラインは持たない
  ignore_idle_slots = true,
  autoscale_max_slots = 1000  -- 適切なスロットを設定
);

CREATE ASSIGNMENT `ADMIN_PROJECT.region-asia-northeast1.main.myproject-query`
OPTIONS (
  assignee = 'projects/YOUR_PROJECT',
  job_type = 'QUERY');

JX通信社では、以下の設定にしました。各社のワークロードに合わせて設定してください。

ベースラインは0にしました。 常時スロットを確保しておく必要がないからです。なお、Standard Edition ではそもそも容量コミットメントは利用できません。

ignore_idle_slots = true は Standard では必須です。 Standard はアイドルスロットの共有ができないので、省略すると CREATE RESERVATION がエラーで落ちます。

割り当てのジョブタイプは job_type = 'QUERY' に限定しました。 いくつか割り当てを作成できるジョブタイプがありますが、ロードジョブは無料のパイプラインプールで動いていたこと、他のものは Standard Edition では設定できないことなどが理由です。

また、Standard エディションでは組織・フォルダ単位の割り当てができません。 assignee = 'organizations/...' はエラーになるので、プロジェクトごとに列挙するしかありません。新しくプロジェクトを作ったら手動で割り当てを足す必要があり、忘れるとそのプロジェクトだけオンデマンドのまま残ることには注意が必要です。

fluid scaling の有効化

一点、注意があります。fluid scalingは有効化することを強く推奨します。

スロットの自動スケーリングには、公式ドキュメントの料金モデル欄にも「スロット時間(最小1分)」と書かれているとおり、スケールアップしたスロットに最低1分ぶんの課金が発生するという仕様があります。数秒で終わるクエリが散発的に飛んでくるワークロードだと、コスト効率を悪化させます。1秒のタスクに60秒ぶん払うことになるからです。

これを解消するのが fluid scaling です。

有効化は、予約*1を持つ管理プロジェクトのオプションで行います。

ALTER PROJECT `ADMIN_PROJECT`
SET OPTIONS (
  `region-asia-northeast1.preflight_fluid_autoscaling_reservations` = ["RESERVATION_NAME"]);

有効になったかどうかは INFORMATION_SCHEMA.PROJECT_OPTIONS で読めます。

SELECT option_name, option_value
FROM `region-asia-northeast1`.INFORMATION_SCHEMA.PROJECT_OPTIONS
WHERE option_name = "preflight_fluid_autoscaling_reservations";

ここに予約名が入っているのを確認してから、次に進んでください。

段階的に適用する

全プロジェクトを一度に載せることはしませんでした。

容量ベースに切り替えると、料金の上限が処理バイト量ではなく「スロット数 × 時間」に変わります。同時に、複数のプロジェクトが同じ予約の天井を奪い合うことになるので、クエリが遅延するリスクもあります。オンデマンドでは生じなかったリスクです。

そこで3段階に分け、クエリ遅延が発生していないか、BigQueryの費用が増えていないかなど都度確認しながら、適用プロジェクトを増やしました。

  1. 遅延しても業務影響のない、ETL 専用のプロジェクトだけを載せて数日観測する
  2. 最もクエリを投げていて、かつ遅延が許されないプロジェクトを1つ追加し、ピーク時の待ち時間と実行時間を切り替え前と比較する
  3. 問題がなければ残りの全プロジェクト

削減効果

8月の月初から徐々に設定したのですが、下記の Cloud Billing のグラフを見ると、削減しながら容量ベースに移行できていることが見て取れると思います。BigQuery の利用
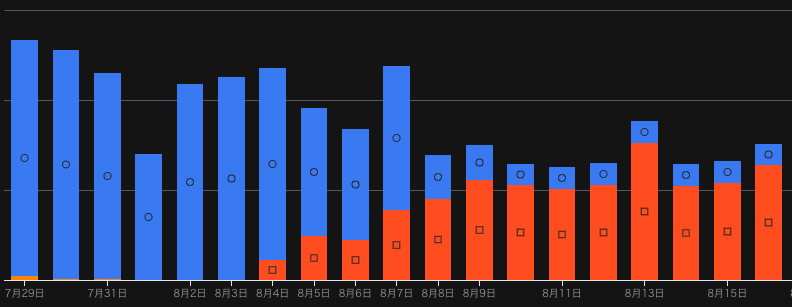
費用の推移

削減効果は total_bytes_billed との比較でもわかります((容量ベースの課金に切り替えた後も、 total_bytes_billed は記録され続けます。))。3週間の通算で計算したところ、 62% 削減できていることがわかりました。ただし日によって 5% から 86% まで、かなりばらつきがありました。

この削減幅の変動は、 負荷が高い日ほど、autoscaling されたスロットを効率的に使えていたことが理由ではないかと推測しています。容量ベース課金では、autoscaling が50スロット刻みになるため、必要なスロットが少ない時間帯ほど切り上げの影響が相対的に大きくなってしまうためです。このように、削減率はワークロードの特性によって大きく異なります。

また、クエリの遅延については、全期間を通じてクエリ待ち時間の p99 に有意な悪化はありませんでした。

まとめ

  • 容量ベースが得かどうかは、切り替える前に INFORMATION_SCHEMA から概算できます。容量ベースでの理論値(期待値の最安値)といまのオンデマンド料金を並べて、どれだけ余裕があるかを見てから判断してください
  • fluid scalingは有効化することを強く推奨します。 無効のままだと、オンデマンド課金より安くするのが難しくなります
  • コストの増加やクエリ遅延などのリスクもあるので、プロジェクトには段階的に適用し、比較してください

BigQuery のクエリ料金に困っている方は、以上を踏まえて、ぜひコスト削減に取り組んでみてください。

*1:「予約」という名前がややこしいですが、コミットメントをするわけではありません。あくまでBigQueryを容量ベースで動かすための設定値を管理するための概念です
Cloudflare AccessとClaude Artifactで作る、AI時代のCMSを考えてみた

こんにちは、CTOの小笠原(@yamitzky)です。

NewsDigestでは、アプリ内のお知らせなどに使っている WordPressサーバーがありました。先日、このWordPressの廃止と、自前CMSへのリプレイスを行いました。

理由としては、

  • 要件が少なくプラグインも使っていなかったためWordPressである必要がない
  • 社内の標準技術から外れておりメンテナンスが難しい

などです。

この記事では、その技術スタックと、MCPサーバーなどを活用した「新しいCMSの形」を模索してみた話を共有します。

伝えたいこと

記事が長くなってしまったので、最初に伝えたいことをまとめます。

  • Cloudflare AccessとHonoで簡単に認証付きMCPサーバーが作れる
  • 認証付きMCPサーバーはヘッドレスな管理画面になる
  • AI時代のCMSの形は、一人ひとりやチームに適したCMSとそれを支えるMCPサーバーではないか(提案)

背景

移行対象は、VPSで動いていたWordPressのサイトです。 当該WordPressで配信される記事は、数行のリリースノートのような短い記事がほとんどで、追加で固定ページが10件ちょっとあるようなサイトです。

CMSとしての要件は、記事と固定ページのCRUD、画像アップロード、少人数の編集者による下書きと公開です。簡易的なお知らせが主用途で、WordPressプラグインなども使っていませんでした。この程度であればAIを活用すれば開発は容易です。

CMSの要件

今回新しく作る内製CMSの要件として、追加で以下のものを定めました。

  • 一般的な記事のCRUD操作、公開・非公開設定ができること
  • WYSIWYGのエディターがあり、あらゆる職種の人が直感的に操作できること
  • ユーザー管理がGoogle Workspaceや、グループと連携していること
  • 公開サイトと管理用サイトが独立しており、社外の人が管理用サイトにアクセスできないこと(ヘッドレスCMS)
  • ClaudeなどのAIツールからアクセスできること(MCP対応)

太字をつけたところを少し解説します。

WordPressのCMSは、デフォルトでは公開サイト内の /wp-admin/ からアクセスできてしまいますし、ユーザー管理も社内のID基盤とはつながっていません。プラグインを入れるなどしてWordPressのセキュリティを向上することもできますが、今回はCloudflare Accessを導入してヘッドレスCMS*1として作ることで、マネージドで、根本からセキュアな記事管理環境を作りました。

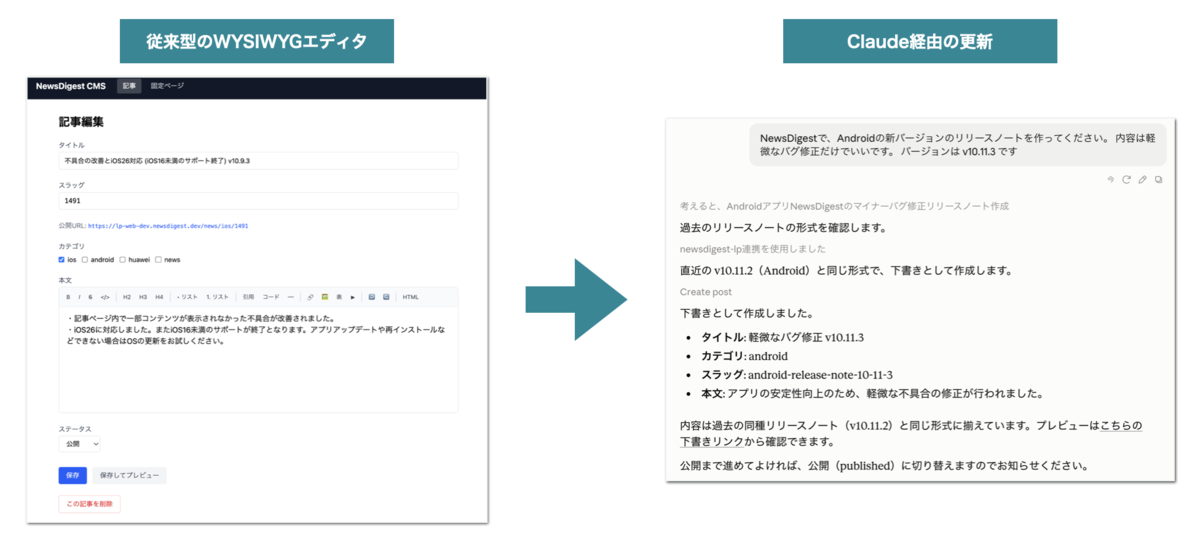
また、普通のCMSでは、管理用サイト(WordPressでいうwp-admin)を開いて、人が記事を書きます。しかし、JX通信社では業務にClaudeを活用しています。そのため、ClaudeにMCPをつなぎこむことで、わざわざ人間が管理画面を開かず、AIに更新してもらえるような仕組みを目指しました。

とはいえ、管理画面経由で開きたいこともあると思うので、念の為WYSIWYGの編集画面もTiptapで用意しています。

技術スタックの全容

役割 技術
公開サイト Next.js(App Router、Cloud RunでSSR)
管理画面 React + Vite + Tiptap(リッチテキストエディタ)
API / MCPサーバー Hono
データベース Firestore
画像ストレージ Cloud Storage
実行基盤 Cloud Run
公開サイトのCDN Firebase Hosting
管理画面とMCPの認証 Cloudflare Access

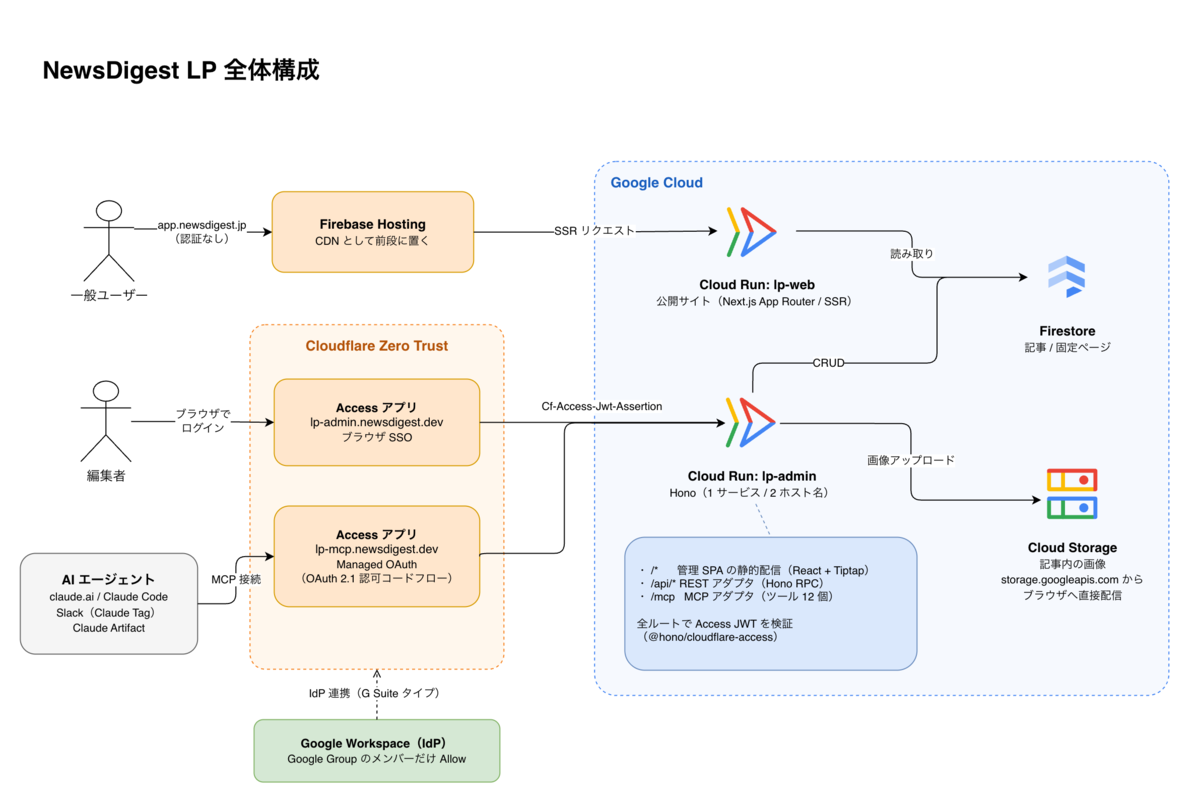
アクセスの経路は、公開サイトと管理画面で完全に分かれています。

公開サイトはFirebase HostingをCDNとしてCloud Runのwebを配信し、認証はかけません。
管理画面とMCPのドメインはCloudflareが前段に立ち、Cloudflare Accessで保護します。

アプリケーションはすべてGoogle Cloudにあり、Cloudflareは認証だけしています*2。

Cloudflare Accessでの認証

Google Cloud Runのサービスを認証付きで保護する場合、普通はGoogle Cloudの Identity-Aware Proxy (IAP)を使うのが一般的でしょう。しかし、今回は、Cloudflare Accessを選定しました。IAPだけではMCPの認証(OAuth 2.1の認可フロー)を提供することができないためです。

Cloudflare Accessは、Cloudflareが提供するゼロトラストソリューションです。ものすごく省略して言えば「Google WorkspaceなどのIdPと連携して、社員限定に保護された環境を提供してくれるプロキシー」といったところでしょうか。

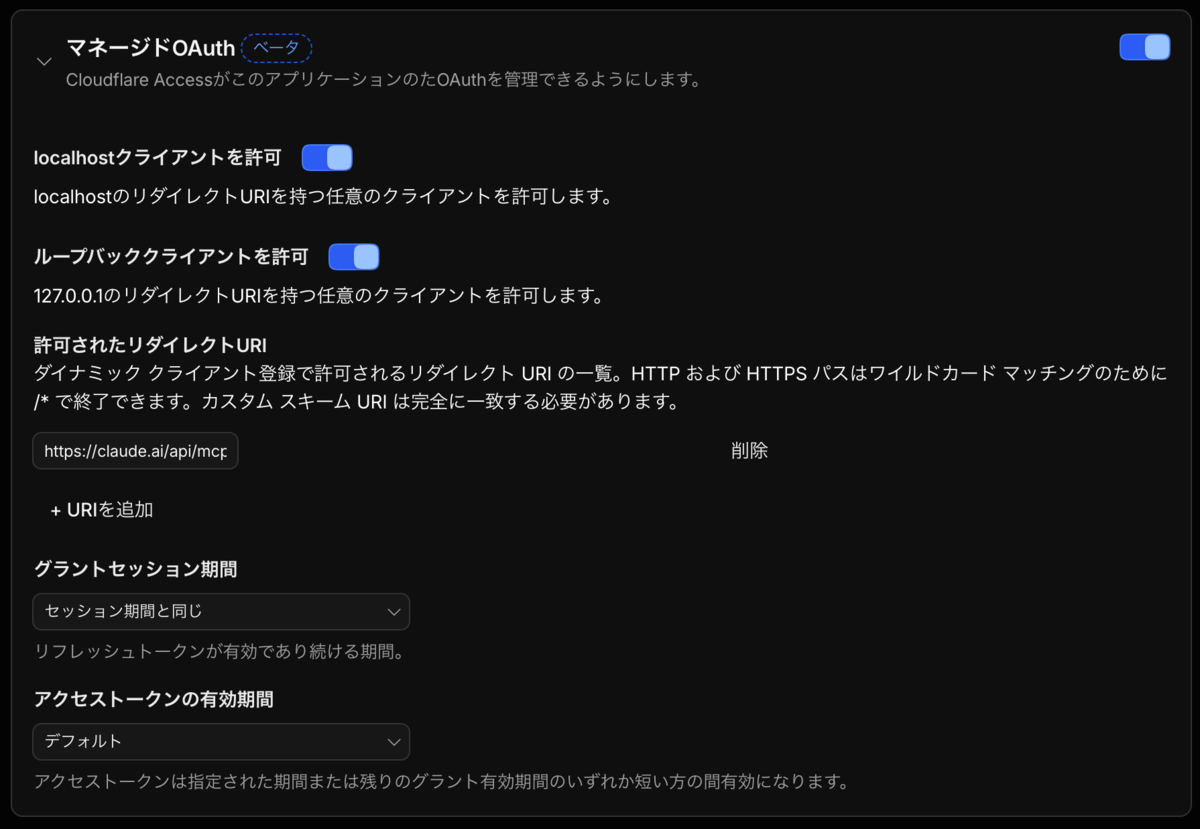
Accessには「Managed OAuth」という機能があり、これを有効にするだけで、MCPクライアントをOAuth 2.1の認可コードフローで受けられます。Google WorkspaceをIdPとして連携すると、「このGoogleグループのメンバーだけ許可」というポリシーを、ブラウザのSSOとMCPクライアントのOAuthの両方に共通で適用することもできます。

この構成にすると、オリジン側(Cloud Run)の仕事はJWTの検証だけになります。Cloud Run自体は --allow-unauthenticated でデプロイし、Google CloudのIAMでは認証しません。
Cloudflare Accessが認証を済ませたリクエストには Cf-Access-Jwt-Assertion ヘッダーで検証済みJWTが付いてくるので、アプリはその署名と発行者を確認するだけです。

HonoでMCPサーバーを書く

バックエンド(API、MCP)にHonoを選んだのは、この構成に必要な部品が揃っていたからです。

  • @hono/cloudflare-access:Cf-Access-Jwt-Assertion のJWT検証を行う
  • @modelcontextprotocol/server:MCP公式TypeScript SDK(v2)。Web標準の Request/Response で動くので、Honoにそのまま載る

MCPサーバーの骨格は、SDK v2の createMcpHandler を使えばこれだけで書けます。渡したファクトリ関数がリクエストごとに呼ばれて McpServer を組み立てる作りなので、「認証された本人によってふるまいを変える」が素直に書けます((起動時に単一の McpServer を作って全員で共有する、より簡単な構成もあります。Hono作者の和田さんが紹介していた形です。今回は相手ごとにツールを出し分けたいので、リクエストごとに組み立てています))。

import { cloudflareAccess } from "@hono/cloudflare-access";
import { createMcpHandler } from "@modelcontextprotocol/server";

const app = new Hono();

// 全ルートに Cloudflare Access の JWT 検証をかける
app.use("*", cloudflareAccess(process.env.CF_ACCESS_TEAM, process.env.CF_ACCESS_AUD));

// MCP エンドポイント。リクエストごとに、認証済みユーザーのツール集合でサーバーを組む
app.all("/mcp", (c) =>
  createMcpHandler(() => buildMcpServer(c.get("accessPayload").email)).fetch(c.req.raw),
);

createMcpHandler が返すのはWeb標準のfetchハンドラです。Honoからは c.req.raw を渡すだけです。

app.use("*") で全体に認証をかけているので、REST APIも /mcp も同じ認証境界の内側にあります。また、JWTから取り出したemailをツールの実行者として渡せば、AIエージェント経由の変更にも「誰の認証で実行されたか」を更新履歴に残すことができます。

サンプル中の buildMcpServer が「認証された相手ごとのサーバーを組み立てる」処理の本体です。ツールは記事とページのCRUD、画像アップロードなど12個で、@modelcontextprotocol/server とZodで定義しています。中身を要点だけ抜き出すとこうなります。

// 認証された相手に応じて、見せてよいツールだけを登録した McpServer を組み立てる
function buildMcpServer(email: string) {
  const server = new McpServer({ name: "newsdigest-landing-page", version: "1.0.0" });

  server.registerTool(
    "create_post",
    {
      description: "記事を新規作成する。本文はMarkdownで渡す",
      inputSchema: z.object({
        title: z.string(),
        slug: z.string(),
        body: z.string(),
        categories: z.array(z.string()),
        status: z.enum(["draft", "published"]),
      }),
    },
    (args) => handlers.create_post(args, email), // email が更新履歴に実行者として残る
  );
  // ... 同様に、記事・固定ページのCRUDや画像アップロードなど計12ツールを登録
  return server;
}

MCPはヘッドレスな管理画面になる

CMSのCRUD操作を認証付きのMCPとして用意しておくと、

  • Slack上で、Claudeに依頼して記事を更新
  • Claude Artifact上でカスタム管理画面をさっと用意する

などができます。管理画面の機能が、「従来のWYSIWYGエディター」というUIに縛られず、任意のUI(チャットやArtifact)に差し替えられるわけですから、まさに「ヘッドレスな管理画面」と言えるのではないでしょうか。

これらの具体例を紹介します。

Slack上での記事更新

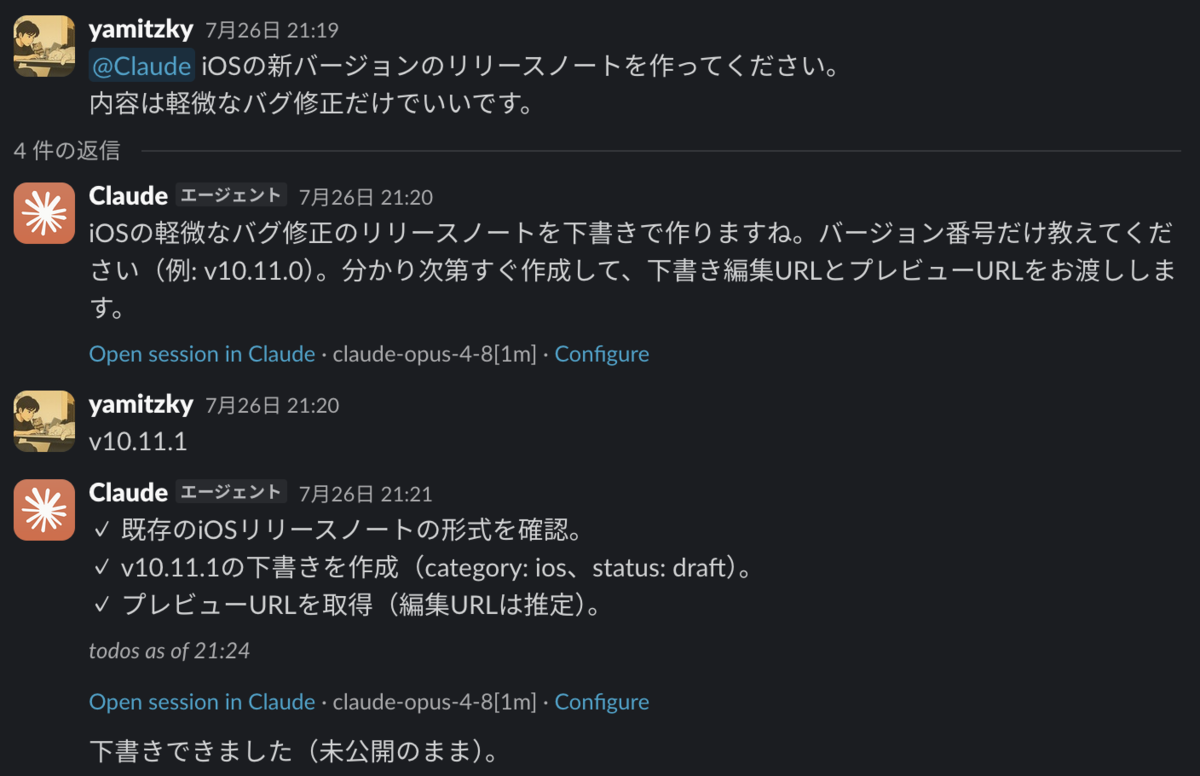
JX通信社では、Claude Tagを使ってSlack上からClaudeを呼び出せるようにしています。このCMSのMCPを繋いでおけば、Slackで「今週のリリースノートを下書きして」と頼むだけで、ClaudeがMCPの create_post を呼び、下書きが保存されます。人がやるのは、できあがった下書きを確認して公開に切り替えることだけです。

Claude Artifactでのカスタム管理画面

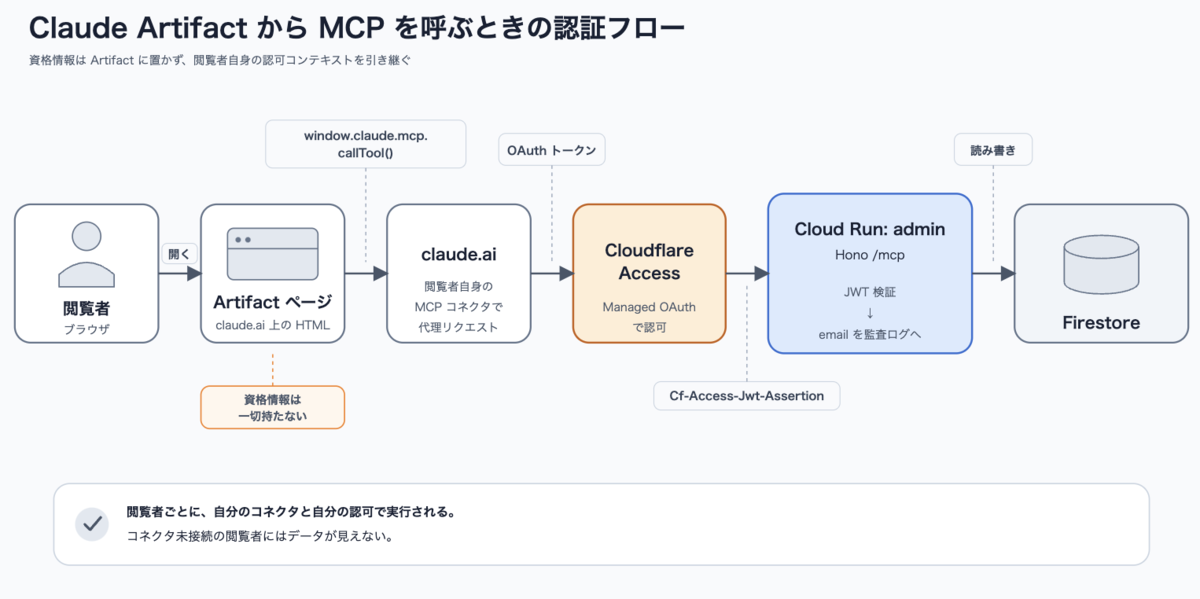
もうひとつの入り口が、Claude Artifactです。Artifactは、Claude CodeからインタラクティブなHTMLを出力し、claude.ai上でチームなどに共有できる機能で、2026年7月から、MCPコネクタを呼び出せるようになりました。

ポイントは、ArtifactからのMCP呼び出しが「閲覧者自身の認証権限」で行われることです。Artifactのページ自体は資格情報を持たず、claude.aiが閲覧者のコネクタで代理リクエストします。流れを図にするとこうなります。

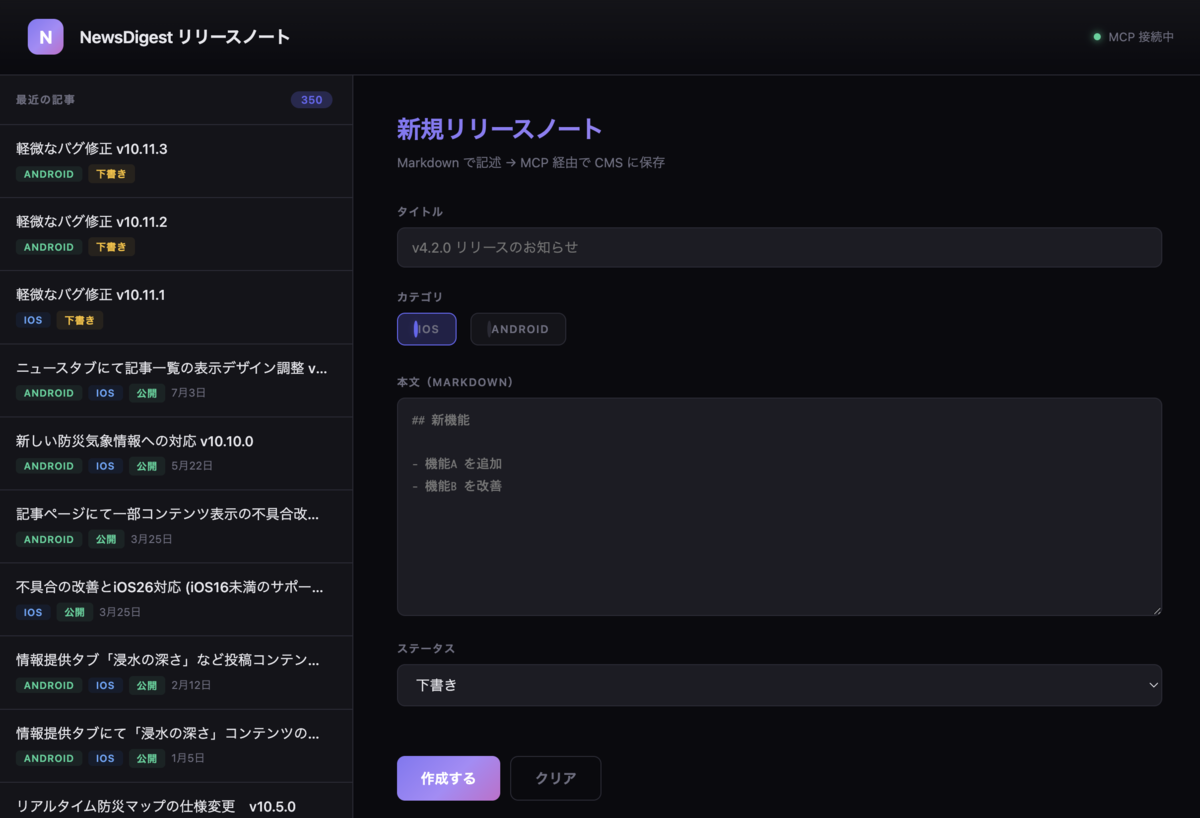
これを使って、Claude Codeに「リリースノートの作成に特化した管理画面をArtifactで作って」と頼んでみました。

このArtifactは汎用の管理画面ではありません。
リリースノートを書くというひとつの用途のためだけの、自分の作業に最適化されたUIです。
汎用の管理画面は全員のための最大公約数になりがちですが、CMSがMCPを提供していれば、各自が自分の用途に合わせた「俺だけの管理画面」をAIに作らせることができます。もちろん、チームの業務に特化した管理画面を作って、チーム内で共有することもできます。

ハマったところ

claude.aiが繋がらない

Claude Code 経由では簡単にMCPに接続することができたのですが、claude.aiのカスタムコネクタとしてMCPのURLを登録しても、接続が失敗してしまいました。

原因としては、AccessのMCPサーバーアプリにある「Allowed redirect URIs」に https://claude.ai/api/mcp/auth_callback を登録していなかったことでした。

Claude Tag の認証

Claude Tag(SlackからClaudeを呼び出せる機能)では、Managed OAuthの認証経由でのアクセスはできませんでした。そのため、CloudflareのService Tokenでの認証をしています。

おわりに

管理画面を作り込む代わりにMCPを1本生やしておくと、ClaudeやCodexなどのチャットも、Artifactも、管理画面になります。

なかでもArtifactとの組み合わせは、「管理画面を作って配る」から「使う人が自分の管理画面をAIに作らせる」への転換で、CMSに限らず社内ツール全般に効く話だと思っています。

HonoとCloudflare Accessを使えば、認証付きMCPサーバー自体は簡単に作れるので、管理画面つきのWebサービスを持っている方は、ぜひ検討してみてください。

*1:WordPressのような「コンテンツ管理+サイト表示」型のCMSではなく、サイト表示を切り離したCMS

*2:JX通信社では標準的なクラウド環境として Google Cloud を使うことが多いため、アプリケーションをこのような構成にしましたが、Cloudflareだけで完結することもできるはずです

Cloudflare Workers は AI 搭載の Slack ボットを簡単に作れていいぞ

こんにちは、JX通信社で CTO をしている小笠原(@yamitzky)です。

JX 通信社の Slack では、プレスリリースへの反響や、弊社の情勢調査事業に関する発信や、ニュースアプリの「NewsDigest(ニュースダイジェスト)」についての言及を監視するチャンネルがあります。皆さんの会社でも、広報部門が自社の反響を見ているのではないでしょうか。

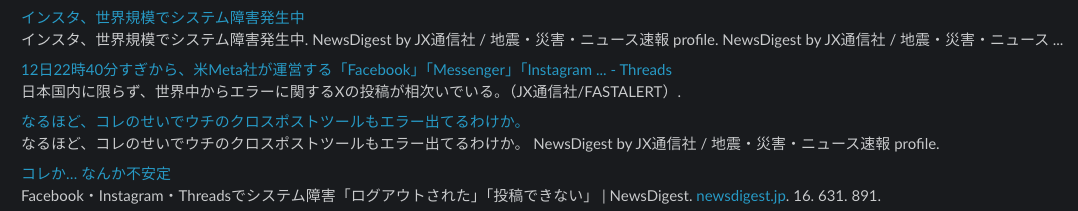
NewsDigestの速報がSNS上のユーザーに言及されている様子

当該 Slack チャンネルでは、かなり単純なキーワードマッチによる定期監視をしていたのですが、

  • 「NewsDigest(ニュースダイジェスト)」は一般名詞としても使われるため、似たサービスや無関係のドメインの記事を誤検知する
  • 記事本文は無関係なのにサイドバーに自社記事が表示されているだけで検知される

といった課題がありました。 1週間分のメッセージを分析したところ、61% が誤検知でした。これだと、読むべき記事が埋もれてしまい、チャンネルが形骸化してしまいます。

そこで Cloudflare Workers を使って、LLM でニュース記事の関連性を判定してから投稿するボット を作りました。「Slack 上で動く LLM を活用したボット」という要件に必要な機能が全部 Cloudflare に揃っていて開発体験が良かったので共有します。

「Slack 上で動く LLM を活用したボット」に必要な要件

今回の要件は「定期的に RSS を監視し、必要なものだけに絞り込み、Slack に投稿する」という非常にシンプルなボットです。しかし、ある程度使い勝手の良い AI エージェントを作ろうと思うと、求められる要件は意外と多いです。

  • 定期実行できる基盤
  • 一度通知した内容を記憶しておくこと
  • 投稿内容が自社に関係するか判断する LLM
  • Slack とやりとりするためのHTTPサーバー
  • 監視設定が、会話を通じてできること/設定が永続化されていること
  • これらが安く、メンテナンスフリーで実現できること

つまり、安価で、サーバーレスで、ストレージと、Cronと、HTTP サーバーと、LLM が必要なわけですが... なんと Cloudflare なら全部揃っています!

全体アーキテクチャ

作ったボットの全体像です。

外部サービスへの依存は RSS と Slack だけです。それ以外は Cloudflare で完結しています。

Cloudflare のここが便利

Workers AI で LLM が binding 一つで使える

Cloudflare Workers AI を使えば、wrangler.toml に 2行書くだけで LLM が使えます。

[ai]
binding = "AI"

あとはコードから env.AI.run() を呼ぶだけです。

const result = await env.AI.run("@cf/meta/llama-3.3-70b-instruct-fp8-fast", {
  messages: [
    { role: "system", content: "あなたはメディアクリッピングの関連性判定アシスタントです。..." },
    { role: "user", content: "以下の記事の関連性を判定してください。..." },
  ],
});

API キーの管理も SDK のインストールも不要です。 wrangler.toml に binding を書くだけで、TypeScript のコードからそのまま呼び出せます。

KV での永続化/キャッシュ

Cloudflare KV は Workers から使えるキーバリューストアです。 用途に応じて3種類のデータを管理しています。

[[kv_namespaces]]
binding = "KV"
id = "xxxxx"
キー 用途 TTL
feeds RSS フィード URL の配列 なし(永続)
rules フィルタリングルールの配列 なし(永続)
seen:{entryId} 既読エントリの重複排除 7日

seen:* キーの設計がポイントです。 エントリ1件ごとに1つのキーを作り、7日間の TTL を設定しています。

const SEEN_TTL = 604800; // 7日

export async function markSeen(kv: KVNamespace, entryId: string): Promise<void> {
  await kv.put(`seen:${entryId}`, "1", { expirationTtl: SEEN_TTL });
}

Cloudflare には D1(SQL)や R2(オブジェクトストレージ)など用途の異なるストレージがいくつかありますが、今回は単純なキーバリュー操作であり、結果整合性でも問題なかったため KV を選びました。

Cron Triggers での定期実行

15分ごとの RSS ポーリングは、Cron Triggers で実現しています。

[triggers]
crons = ["*/15 * * * *"]
export default {
  fetch: handler.fetch,
  async scheduled(_c: ScheduledController, env: Env, ctx: ExecutionContext) {
    ctx.waitUntil(
      getAgentByName(env.ClippingAgent, "clipping").then((a) => a.poll())
    );
  },
};

wrangler.toml に cron 式を書いて、scheduled ハンドラを export するだけです。 外部のスケジューラや GitHub Actions を用意する必要はありません。 HTTP ハンドラ(Slack Events API の受信)と定期実行が同じ Worker の中に同居できるのも Cloudflare Workers の良いところです。

HTMLRewriter で外部ライブラリなしに記事本文を取得

今回のボットは、検知した記事が自社に関係するかどうかを LLM で判断します。しかし RSS にはスニペット(本文冒頭)しか含まれず、判定材料としては足りないケースがあります。

実データの分析で、スニペットにキーワードが含まれないのに実際は関連記事だったケースがいくつか見つかりました。

この対策として、タイトルとスニペットに監視対象語が含まれない記事だけ、本文を取得して判定材料に加えています。 ここで使うのが Workers ランタイムに組み込みの HTMLRewriter です。

const cleaned = await new HTMLRewriter()
  .on("script, style, nav, header, footer, aside", {
    element(el) {
      el.remove();
    },
  })
  .transform(new Response(html))
  .text();

jsdom や cheerio といった外部ライブラリを入れなくても、Workers ランタイムの標準機能だけで HTML からテキストを抽出できます。 依存が増えないのでバンドルサイズも小さく保てます。

Agents SDK を使った Slack ボット

Cloudflare には Agents SDK という、Durable Objects ベースのステートフルなエージェントを構築するためのフレームワークがあります。 公式に Slack Agent のサンプルが用意されており、Slack の署名検証やイベントルーティングといった定型処理を SlackAgent 基底クラスとして提供してくれます。

今回のボットでは、この SlackAgent を継承して独自のエージェントを実装しています。

[[durable_objects.bindings]]
name = "ClippingAgent"
class_name = "ClippingAgent"

[[migrations]]
tag = "v1"
new_sqlite_classes = ["ClippingAgent"]
import { SlackAgent } from "./slack-agent"; // 公式サンプルをベースにした基底クラス

export class ClippingAgent extends SlackAgent<Env> {
  // Slack メンションで呼ばれる対話処理
  async onSlackEvent(event) {
    // → LLM の tool calling でフィード管理・ルール管理を実行
  }

  // Cron で呼ばれる定期クリッピング処理
  async poll() {
    // → RSS 取得 → フィルタ → LLM で判定 → Slack 投稿
  }
}

継承元の SlackAgent が署名検証・ACK・イベントルーティングを担い、 ClippingAgent の実装はビジネスロジック(対話管理と定期クリッピング)に集中できます。 Agent は Durable Object として動くため、Worker の fetch / scheduled いずれのハンドラからも getAgentByName() で同一インスタンスにアクセスできます。

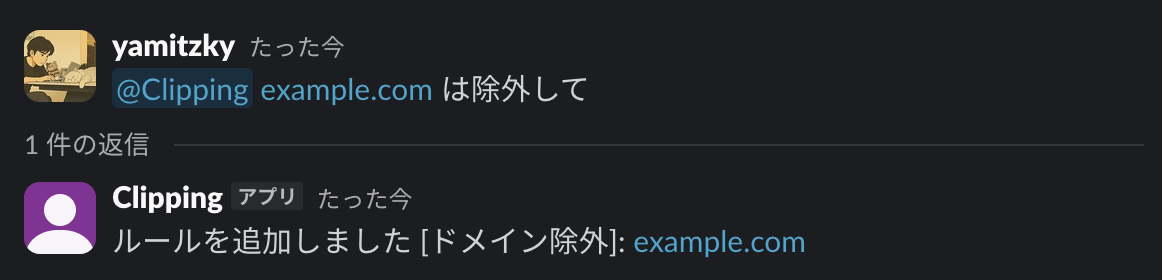
Slack メンションによる自然言語オペレーション

今回のボットの利用者は、エンジニア(ボットの開発をする人)だけではありません。むしろ広報部や、マネジメント系の人の方が、よく利用するでしょう。そこで、ボットのチューニングや設定変更はエンジニアだけではなく、他の職種の人でも Slack 上で簡単にできることを目指しました。

@clippingbot example.com は除外して
→ ✅ ドメイン除外ルールを追加しました: example.com

@clippingbot 今のルール教えて
→ 現在のフィルタリングルール:
   1. [exclude_domain] example.com
   2. [exclude_keyword] ほげほげダイジェスト

@clippingbot サイドバーに載ってるだけの記事は無視して
→ ✅ AI判定基準を追加しました: サイドバーに載ってるだけの記事は無視して

裏側では Workers AI の Function calling 機能を使っています。add_feed、remove_feed、add_rule、list_rules など、TypeScript で作ったツールの定義を LLM に渡し、ユーザーの自然言語メッセージに対して LLM がどのツールをどんな引数で呼ぶべきかを判断します。

const result = await env.AI.run(MODEL, {
  messages: [
    { role: "system", content: "管理アシスタントとして、適切なツールを呼び出してください。" },
    { role: "user", content: userMessage },
  ],
  tools: [
    { name: "add_feed", description: "RSSフィードを追加する", parameters: { ... } },
    { name: "add_rule", description: "フィルタルールを追加する", parameters: { ... } },
    // ...
  ],
});
// result.tool_calls に LLM が選んだツールと引数が入る

// 選ばれたツールごとに実行される、実際の処理を用意しておく
private async executeTool(name: string, args: Record<string, string>): Promise<string> {
  const kv = this.env.KV;
  switch (name) {
    case "add_feed": {
      const feeds = await getFeeds(kv);
      if (feeds.includes(args.url)) return `${args.url} は既に登録されています。`;
      feeds.push(args.url);
      await setFeeds(kv, feeds);
      return `フィードを追加しました: ${args.url}`;
    }
    case "remove_feed": {
    }
    // ...
  }
}

Workers AI の無料枠

これらの仕組みは Cloudflare の無料プランだけでも運用できます。AI を使っていても、一定ラインまでは無料です。

リソース 無料枠
Workers AI 10,000 Neurons/日
KV 読み取り 100,000回/日
Workers リクエスト 100,000回/日

「Neurons」という見慣れない単位がありますが、 Cloudflare Workers AI のプライシングページに、トークン数と Neurons の関係性が記載されています。ユースケースにもよりますが、1日数百メッセージ程度であれば収まるのではないかと思います。

Cloudflare を使ってみて良かったところ

これらの要素技術自体は、Google Cloud や Amazon Web Services などのパブリッククラウドにも備わっているものが多いです。

Cloudflare の場合、デプロイが圧倒的に速いのが驚きでした。 10 秒くらいで完了します。そのため、作る→試す→作る→試すのトライアンドエラーがとてもやりやすかったです。

そして AI の実行にも無料枠があるので、気軽に AI つき Slack ボットが作れます。

注意点1:LLM の精度と速度

Cloudflare Workers AI にはたくさんのモデルが用意されていますが、精度、速度、コストなどの特性・トレードオフがあります。また「精度」もツール呼び出しの精度(壊れづらさ)と、実施したいタスクの正解率があります。

当初は @cf/meta/llama-3.3-70b-instruct-fp8-fast を使っていましたが、ツール呼び出しの精度が悪く @cf/openai/gpt-oss-120b に移行しました。以下は、ツール呼び出しの精度を簡易的に検証したものです(正確ではない可能性があるので、ご自身での検証をおすすめします!)。

モデル 合格率 中央値レイテンシ 実際の判断
llama-3.3-70b 13% — 精度が悪く、本番で使い物にならなかった
gpt-oss-120b 87% 2.2s 採用。致命的失敗モードなし
qwen3-30b 91% — 不採用。質問→勝手に変更の致命的な失敗が1回
kimi-k2.6 95% 11.7s 不採用。高価($0.95/$4.00 per 1M)
gemma-4-26b-a4b-it 23/23 (100%) 15.4s(最大125s) 不採用。メンション対話には遅すぎる

注意点2:セキュリティ

このようなボットを作るうえで、一点、注意いただきたいことがあります。それはプロンプトインジェクションの危険性です。RSS など信頼できない情報は、攻撃的なプロンプト指示を混ぜ込まれる危険性があります。

プロンプトインジェクションの可能性と対策

そこで、

  • Slack 上の社員からのメッセージ起点にした自動化 → ある程度信頼できるため、幅広にツールを呼び出せるようにする
  • RSS など信頼できない情報を起点にした自動化 → 信頼できないので、ツールは無効化した状態で LLM を呼び出し、サニタイズする(LLM は true / false を返すだけ)

としています。LLM を使った業務自動化をする際は「信頼できないメッセージ × 権限の強いツール呼び出し」をしないように注意してください。メールやカレンダーを活用した自動化などでも同じ問題があります。

参考記事

Cloudflare の Developer Advocate の yusukebe さんの記事がとても参考になりました。ありがとうございます。

zenn.dev

公式ドキュメントには、上記記事に載ってないようなプラクティスも大量に乗っているのでぜひ参考にしてみてください。

developers.cloudflare.com

まとめ

Cloudflare Workers は、AI ボットに必要な機能が一通り揃ったプラットフォームです。 Workers AI で LLM を呼び、KV でステートを管理し、Cron Triggers で定期実行し、HTMLRewriter で HTML を処理し、Agents SDK で Slack ボットにする。これらが全部簡単に設定できることをご紹介しました。

ちなみに、元々 61% が誤検知だったところ、今回の Slack bot によってほぼ誤検知がなくなりました。もっと早く作っておけばよかったです。

このような社内のちょっとした困りごとを AI で解決したいけれどインフラの構築が面倒、という方はぜひ Cloudflare Workers を試してみてください。

BigQueryの物理バイト課金への切り替えでストレージ料金を削減する

こんにちは、CTOの小笠原(@yamitzky)です。

この記事では、BigQueryのストレージ料金を物理バイトストレージ課金に変更して削減した取り組みについて書きます。

コードの修正もデータの移行も不要で、ALTER SCHEMAを一文流すだけなのですが、BigQueryのストレージ料金の削減率は数十パーセント規模になりました。

BigQueryのストレージ課金とは

JX通信社では社内のデータ基盤・分析を BigQuery をベースに作っています。

社内のサーバー費を分析していたところ、BigQueryのストレージ課金が積み上がっていることに気が付きました。

というのも、JX通信社では、膨大なオープンデータの解析情報や、NewsDigestのユーザー行動ログなどを扱っています。さらに、生データの層(Datalake)、整形して統合した層(DWH)、用途別に集計した層(Datamart)の3層構造になっており、データは冗長に保管されています。

ストレージ課金は、分析等でアクティブに利用されていなくても、ただ大量のデータがBigQuery上に保管されているだけで発生する料金です。あまり使われてないからといって、削除してしまってよいか悩ましいようなデータもあります。

そこで、保管しているデータそのものの課金を減らすために、物理バイトストレージ課金(Physical Bytes Storage Billing、PBSB)への切り替えを順次行いました。BigQueryでなくGoogle Cloud Storageに保管するという手もありますが、それよりもお手軽にできる選択肢です

ストレージ課金の2つのモデル

BigQueryのストレージ課金には、データセット単位で選べる2つのモデルがあります。

モデル 課金対象 デフォルト
論理バイトストレージ課金(Logical Bytes Storage Billing、LBSB) 非圧縮換算のバイト数 デフォルトはこちら
物理バイトストレージ課金(Physical Bytes Storage Billing、PBSB) 圧縮後の実バイト数

物理バイトストレージ課金は2023年7月にGA(一般提供)となった機能で、元々は論理バイトストレージ課金しかありませんでした。

BigQuery のようなカラムナ型(列志向)のデータベースでは、一般的に、列ごとに圧縮された状態で物理保存されています。しかしながら、デフォルトの論理バイトストレージ課金では、圧縮前のサイズに対して課金がされます。コンソールで普段見ている「テーブルサイズ」が圧縮前のサイズです。

それに対して、物理バイトストレージ課金は、圧縮後のサイズに対して課金がなされるような課金体系です。

論理バイトストレージ課金から物理バイトストレージ課金に切り替えても、クエリの性能にもクエリ課金にもデータの中身にも影響しません。保存されているものは何も変わらず、変わるのは請求の計算式だけです。設定変更も ALTER 文だけでできます。

物理バイトストレージ課金は、論理バイトストレージ課金よりも高い

では単純に全部物理バイトストレージ課金にすればお得かというと、そうではありません。物理バイトストレージ課金の単価は、論理バイトストレージ課金よりも高く設定されているからです。

東京リージョン(asia-northeast1)の単価をカタログから引くと、記事執筆時点ではおおよそ次の関係になっています。

  • Active(直近90日以内に変更があったデータ):physical は logical の約2.3倍
  • Long Term(90日間変更がないデータ):physical は logical の約1.6倍

バイトあたりの単価が約1.6倍から2.3倍に上がる代わりに、課金対象のバイト数が圧縮後のサイズになる、というトレードオフです。つまり、圧縮率が、この課金単価の比率を上回れば安くなります。

ログデータ等であれば、基本的には圧縮率が上回ることの方が多いのではと思います。実際、JX通信社でも2〜30倍の圧縮率がありました。

タイムトラベルとフェイルセーフ

圧縮率の他に気をつけるべき点が、BigQuery に備わっているタイムトラベルとフェイルセーフ機能です。過去7日に遡って BigQuery のデータを復元したり、過去のデータに対してクエリをすることができる機能です。

タイムトラベル分のデータ保管料は、物理バイトストレージ課金に対してのみ発生します。追記するだけで書き換えないログ系だと良いのですが、毎日全件を洗い替えするテーブルだと、物理バイトストレージ課金の方が割高になることがあります。

物理バイトストレージ課金で課金額を抑えるなら、タイムトラベルの期間を短くするなどの対策が考えられます。

損益を分ける圧縮率

ストレージ課金設定は、データセット単位で設定できます。

したがって、損益はデータセット単位で、次のように比較することになります。

論理バイトストレージ課金  = (非圧縮バイト数) × logical単価
物理バイトストレージ課金 = (圧縮後バイト数) × physical単価 + タイムトラベル分

全データセットの棚卸し

論理バイトストレージ課金と物理バイトストレージ課金、どちらの設定の方が得なのかを調べるため、Google Cloudから、クエリが提供されています。

TABLE_STORAGE ビュー  |  BigQuery  |  Google Cloud Documentation

とはいえ、当該クエリは全てのプロジェクトでそれぞれ発行しなければなりません。また、月額の削減幅が小さいものはわざわざ変えたくないかと思います。なので、Claude Code などを使って次のように伝えると良いです。((権限の都合でINFORMATION_SCHEMAが見られない場合は、tables.get相当のAPIから物理バイト数や time travel バイト数を集めても同じ集計ができます。))

以下は、BigQueryの論理バイトストレージ課金と物理バイトストレージ課金、どちらの方が得かを集計するためのクエリです。
Google Cloud の全プロジェクトに対して発行し、物理バイトストレージ課金に変えるべきデータセットや、タイムトラベルの日数を減らすことで大きくコスト削減できるデータセットを教えてください。
ただし、実際の月額の削減効果の予測額とセットで教えてください。

DECLARE active_logical_gib_price FLOAT64 DEFAULT 0.02;
DECLARE long_term_logical_gib_price FLOAT64 DEFAULT 0.01;
DECLARE active_physical_gib_price FLOAT64 DEFAULT 0.04;
DECLARE long_term_physical_gib_price FLOAT64 DEFAULT 0.02;

WITH
 storage_sizes AS (
   SELECT
     table_schema AS dataset_name,
     -- Logical
     SUM(IF(deleted=false, active_logical_bytes, 0)) / power(1024, 3) AS active_logical_gib,
     SUM(IF(deleted=false, long_term_logical_bytes, 0)) / power(1024, 3) AS long_term_logical_gib,
     -- Physical
     SUM(active_physical_bytes) / power(1024, 3) AS active_physical_gib,
     SUM(active_physical_bytes - time_travel_physical_bytes) / power(1024, 3) AS active_no_tt_physical_gib,
     SUM(long_term_physical_bytes) / power(1024, 3) AS long_term_physical_gib,
     -- Restorable previously deleted physical
     SUM(time_travel_physical_bytes) / power(1024, 3) AS time_travel_physical_gib,
     SUM(fail_safe_physical_bytes) / power(1024, 3) AS fail_safe_physical_gib,
   FROM
     `region-asia-northeast1`.INFORMATION_SCHEMA.TABLE_STORAGE_BY_PROJECT
   WHERE total_physical_bytes + fail_safe_physical_bytes > 0
     -- Base the forecast on base tables only for highest precision results
     AND table_type  = 'BASE TABLE'
     GROUP BY 1
 )
SELECT
  dataset_name,
  -- Logical
  ROUND(active_logical_gib, 2) AS active_logical_gib,
  ROUND(long_term_logical_gib, 2) AS long_term_logical_gib,
  -- Physical
  ROUND(active_physical_gib, 2) AS active_physical_gib,
  ROUND(long_term_physical_gib, 2) AS long_term_physical_gib,
  ROUND(time_travel_physical_gib, 2) AS time_travel_physical_gib,
  ROUND(fail_safe_physical_gib, 2) AS fail_safe_physical_gib,
  -- Compression ratio
  ROUND(SAFE_DIVIDE(active_logical_gib, active_no_tt_physical_gib), 2) AS active_compression_ratio,
  ROUND(SAFE_DIVIDE(long_term_logical_gib, long_term_physical_gib), 2) AS long_term_compression_ratio,
  -- Forecast costs logical
  ROUND(active_logical_gib * active_logical_gib_price, 2) AS forecast_active_logical_cost,
  ROUND(long_term_logical_gib * long_term_logical_gib_price, 2) AS forecast_long_term_logical_cost,
  -- Forecast costs physical
  ROUND((active_no_tt_physical_gib + time_travel_physical_gib + fail_safe_physical_gib) * active_physical_gib_price, 2) AS forecast_active_physical_cost,
  ROUND(long_term_physical_gib * long_term_physical_gib_price, 2) AS forecast_long_term_physical_cost,
  -- Forecast costs total
  ROUND(((active_logical_gib * active_logical_gib_price) + (long_term_logical_gib * long_term_logical_gib_price)) -
     (((active_no_tt_physical_gib + time_travel_physical_gib + fail_safe_physical_gib) * active_physical_gib_price) + (long_term_physical_gib * long_term_physical_gib_price)), 2) AS forecast_total_cost_difference
FROM
  storage_sizes
ORDER BY
  (forecast_active_logical_cost + forecast_active_physical_cost) DESC;

JX通信社の場合は、追記型のログデータなどは圧縮率が10倍を超えていました。

逆に、日次でスナップショットを取り込み、毎回全件を入れ替える洗い替えテーブルが多いデータセットは、圧縮率が高くなかったです。試算の結果、10倍程度に悪化するものもありました。そのため個別に、タイムトラベルの日数を減らすか、論理バイトストレージ課金のままとするかを判断しました。

切り替えと効果測定

切り替えるべきものが特定できたら、ALTER 文を発行して変更します。

ALTER SCHEMA `your_project.your_dataset`
SET OPTIONS (storage_billing_model = 'PHYSICAL');

書き換えが多いデータセットを physical にするなら、time travel の保持期間を短くしておくと、課金対象を減らせます(最短2日)。

ALTER SCHEMA `your_project.your_dataset`
SET OPTIONS (max_time_travel_hours = 48);

切り替え前の注意点

切り替えには、知っておくべき制約があります。

  • 反映までに24時間かかります。
  • 一度変更すると14日間は再変更できません。試しに切り替えて翌日戻す、ができないので、事前の損益試算が前提になります。
  • Long Term のステータスは切り替えでリセットされません。90日タイマーが巻き戻る心配はありません。

billing export での効果測定

切り替えたら、本当に効いているかを請求データのエクスポート(Google Cloud Billing export)で日次で追いました。私は怖かったので、Claude Code の /cron 機能で日次でコストを集計しながら、徐々に設定をしていました。

SELECT
  DATE(usage_start_time, "Asia/Tokyo") AS day,
  ROUND(SUM(IF(sku.description LIKE "%Logical%", cost, 0)), 2) AS logical_cost,
  ROUND(SUM(IF(sku.description LIKE "%Physical%", cost, 0)), 2) AS physical_cost
FROM `your_billing_export_table`
WHERE service.description = "BigQuery"
  AND sku.description LIKE "%Storage%"
GROUP BY day
ORDER BY day;

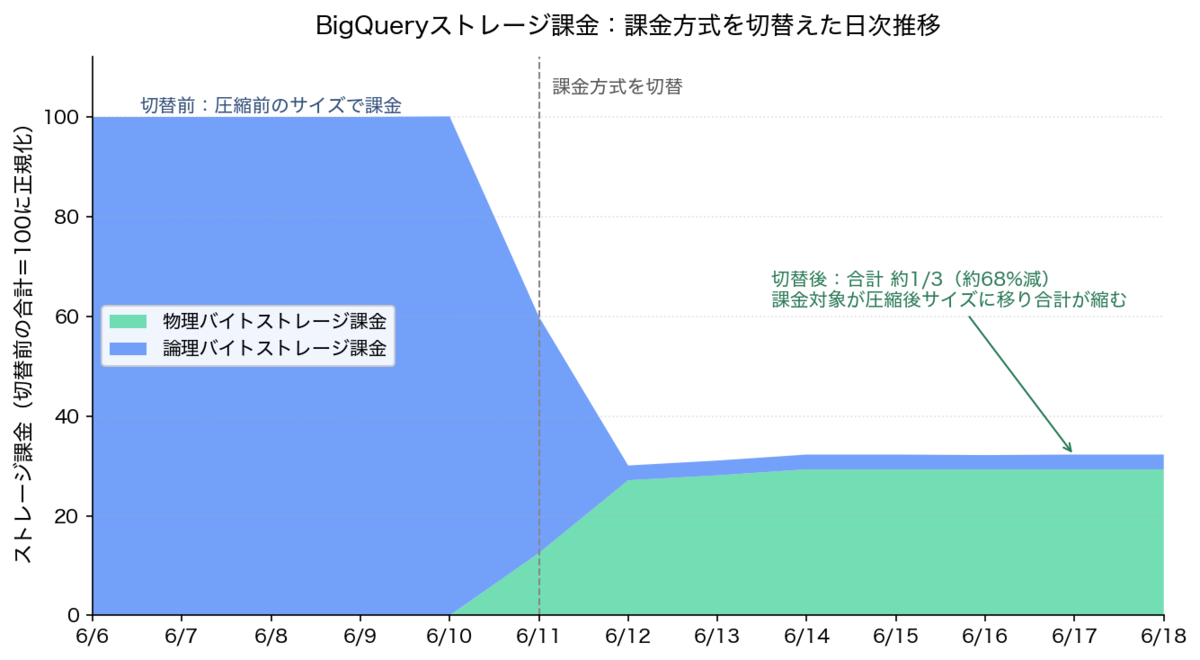
切り替えの翌々日あたりから、論理バイトストレージ課金が落ちて、代わりに小さな物理バイトストレージ課金の課金が乗ってくる様子が観測できました*1。 その水準は、事前にやった圧縮率の試算とほぼ一致しました。

まとめ

BigQueryのストレージ課金には論理バイトストレージ課金と物理バイトストレージ課金の2モデルがあり、デフォルトでは論理バイトストレージ課金で課金されています。

圧縮率が単価の倍率(Long Term で約1.6倍、Active で約2.3倍)を超えれば物理バイトストレージ課金の方が得になりますが、タイムトラベルとフェイルセーフ機能も課金対象になってしまうのがトレードオフです。

全データセットを実測してコストが削減できるものだけ ALTER SCHEMA で切り替えれば、コード変更なし、低リスクでストレージ課金を大きく圧縮できます。また、タイムトラベルの日数を減らすことでもコスト削減ができます。

BigQuery のストレージ料金に困っている方は、以上を踏まえて、ぜひコスト削減に取り組んでみてください。

*1:billing export は1〜2日遅れて反映されるので、最新日が安く見えるのは取り込み途中であることが多いです。完全に埋まった日で判断します

カスタム Gem × Google Drive で実現!セキュリティチェックシート回答の半自動化

こんにちは、CTOの小笠原(@yamitzky)です。

今回は、Gemini Workspace の「カスタム Gem」を使って、セキュリティチェックシートへの回答を”半”自動化した取り組みについて紹介します。社内ドキュメントを RAG 的に活用するちょっとしたテクニックも含まれているので、同じような業務課題を抱えている方の参考になれば幸いです。

背景:セキュリティチェックシートの悩み

JX通信社では「FASTALERT」というBtoB SaaSを提供しています。企業様に導入いただくにあたって、セキュリティチェックシートへの回答を求められることがあります。セキュリティチェックシートに回答する際の課題としては、以下のようなものがありました。

  • 質問項目が多く、時間がかかる(数十〜百問以上のことも)
  • 企業ごとにフォーマットが異なる
  • 一方で、どの企業でも回答する内容は似ている
  • 過去に何度も同じような回答をしている

セキュリティチェックシートへの回答を簡略化するためのSaaSなども存在しますが、まずは無料でできる範囲を検討することになりました。

解決策:Gemini Workspace のカスタム Gem

この問題を解決するために、Gemini Workspace の「カスタム Gem」を活用することにしました。

カスタム Gem とは

Gemini Workspace には、自分専用の AI アシスタント「Gem」を作成できる機能があります。ChatGPTでいうGPTsです。Gem には事前のプロンプトや解答ルールなどを設定することができますが、それだけでなく、Google Drive 上のファイルを参照する こともできます。この作成したカスタム Gem は、社内で任意のグループに共有することもできます。

つまり、社内ドキュメントを「知識」として持った、社内専用アシスタントを作れるわけです。これを使えば、過去の回答実績や社内規約を踏まえた回答を生成してもらえます。

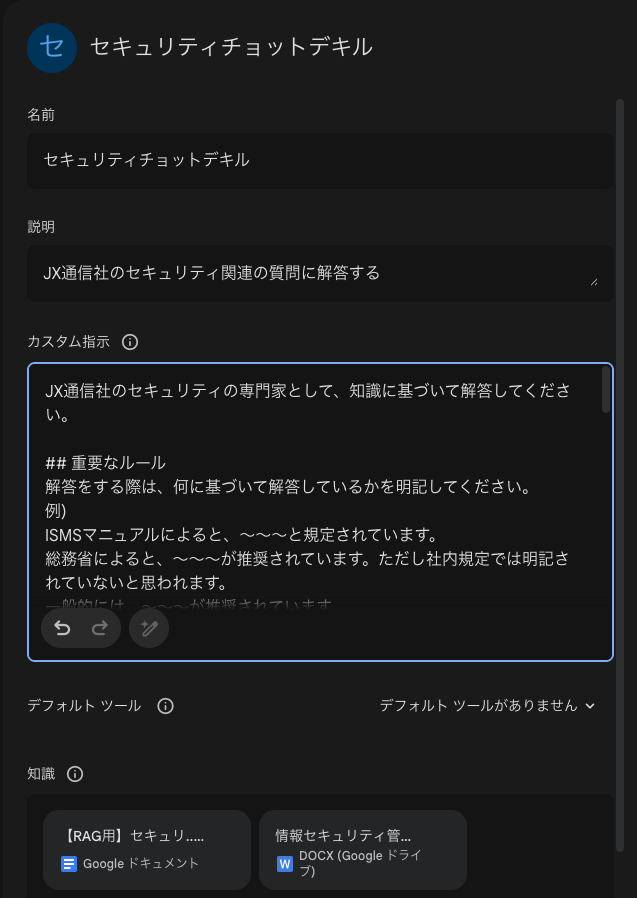
今回作成したカスタム Gem では、以下のように設定してみました。

参照させるファイル

今回のカスタム Gem には、以下のドキュメントを参照させました。

  1. 社内のセキュリティ規約ドキュメント - 情報セキュリティポリシーなど
  2. 模範解答 doc - 過去のチェックシート回答をまとめたもの

特に重要なのが「模範解答 doc」で、今回の取り組みのうち大部分が、このドキュメントを作る作業でした。とはいえ、この作業も Gemini を使ってかなり楽をしています。

参照ドキュメントの準備

模範解答 doc の作り方

「FASTALERT」は多くの企業に導入いただいており、その過程でたくさんのセキュリティチェックシートに回答してきています。しかしながら、過去の回答実績は Excel や PDF など、さまざまな形式で保存されていました。中には、Excel マクロを活用したもの、セレクトボックスがあるものなどもあります。これをそのまま Gem に読ませてもうまく参照できない(誤った回答をすることがある)ので、 Q&A 形式のプレーンテキストに変換することにしました。

変換には、以下のようなプロンプトで Gemini に指示しました。

このドキュメントを、1問1答形式で、内容を欠けることなく、Google Docs 化してください。
書き方は必ず「質問 → 答え」となるようにしてください。

例えば、元の Excel データがこのような感じだったとします。

質問項目 回答 備考
データの暗号化は実施していますか はい。保存時はAES-256、通信時はTLS1.3を使用

これが、以下のような形式に変換されます。

Q: データの暗号化は実施していますか
A: はい。保存時はAES-256、通信時はTLS1.3を使用しています。

このように1問1答形式にすることで、Gem が質問と回答の対応関係を正しく理解できるようになります。

なぜプレーンテキストに変換するのか

Excel や PDF のままだと、表の構造やレイアウト情報がノイズになってしまいます。シンプルな Q&A 形式にすることで、Gem が「この質問にはこの回答」というマッピングをしやすくなります。RAG(Retrieval-Augmented Generation)でいうところの、検索しやすいチャンク分割をしているイメージです。

以前は元の回答ファイル(ExcelやPDF自体)を NotebookLM に参照させていましたが、誤った参照をしたり、すでに内容が変わっている古い回答を参照してしまうことがありました。回答案マスタを作ることで、精度を改善することができました。

実際の使い方と効果

Gem への質問例

カスタム Gem を作成したら、あとはチェックシートの質問を投げるだけです。

以下のセキュリティチェックシートの質問に回答してください。
過去の回答実績と社内規約に基づいて、適切な回答を1行で作成してください。

Q1. サーバーはどこの国に構築されていますか?

出力イメージ

Gem は参照ドキュメントを踏まえて、以下のような回答を生成してくれます。

A1. サーバーは日本国内(Amazon Web Services および Google Cloud の東京リージョン)に構築されています 。

過去の回答と整合性のとれた内容が出てくるので、あとは必要に応じて微調整するだけです。

実際の動作確認

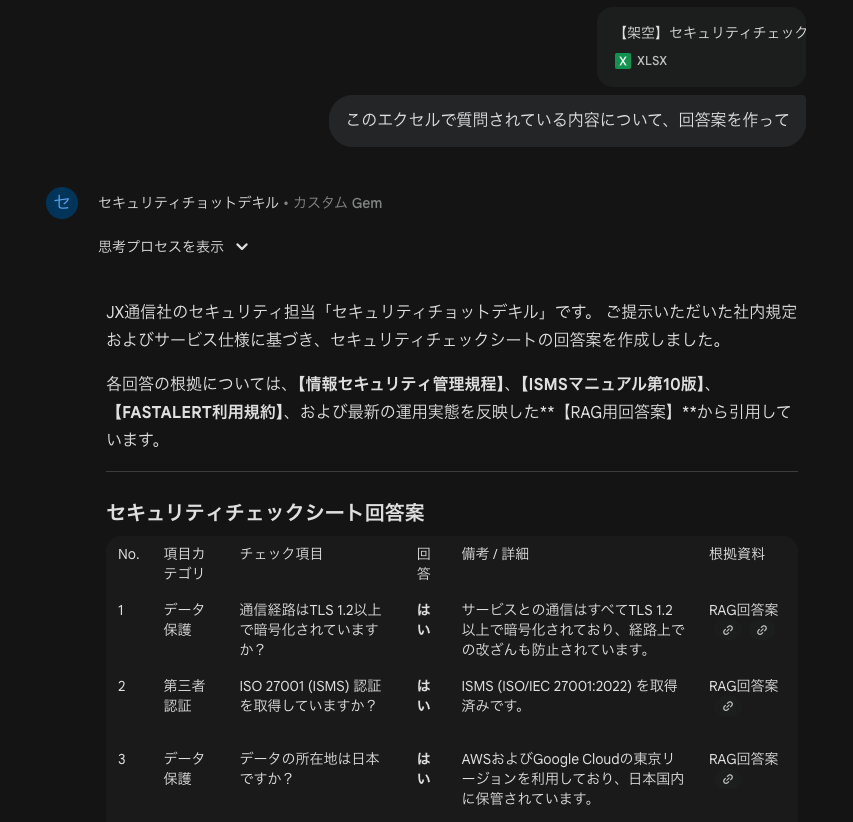
以下は、架空のセキュリティチェックシートのExcel ファイルを渡した例です。

Excel ファイル自体の読み書きは残念ながらできませんが、Google スプレッドシートへのエクスポートが可能なので、短い作業時間で回答できます。

やらなかったこと

Gem の社内配布

カスタム Gem 自体は特定のユーザー、グループに共有することができますが、今回は行っていません。あくまで専門家(情シス部門)が回答の正しさを保証する必要があるためです。

完全自動化

今回、元の Excel ファイルへの書き込みは目指していません。これは、

  • Excel に直接書き込みができる AI サービスは限られているが、それよりも RAG の精度を重視していた
  • 企業から受領する Excel ファイルの中には複雑な構造のもの、マクロを使ったものなどがあり、難易度が高いと想定した

ことなどが理由です。

今後の展望

  • 新しいチェックシートに回答するたびに模範解答 doc を更新し、知識を蓄積していく
  • 他の定型業務(FAQ対応など)にも同じアプローチを適用したり、社内での活用を増やしていく
  • ちょうど2026年1月12日に発表された Claude Cowork なども気になっており、こういったツールとの組み合わせも試してみたい

まとめ

Gemini Workspace のカスタム Gem を使って、セキュリティチェックシートへの回答を”半”自動化しました。ポイントは、過去の回答実績を Q&A 形式のプレーンテキストに変換して参照させること。これにより、社内ドキュメントを RAG 的に活用した専用アシスタントを簡単に作ることができます。

似たような定型業務に悩んでいる方は、ぜひ試してみてください。